연구
공유저작물 권리 메타데이터 추출 2024 – 현재
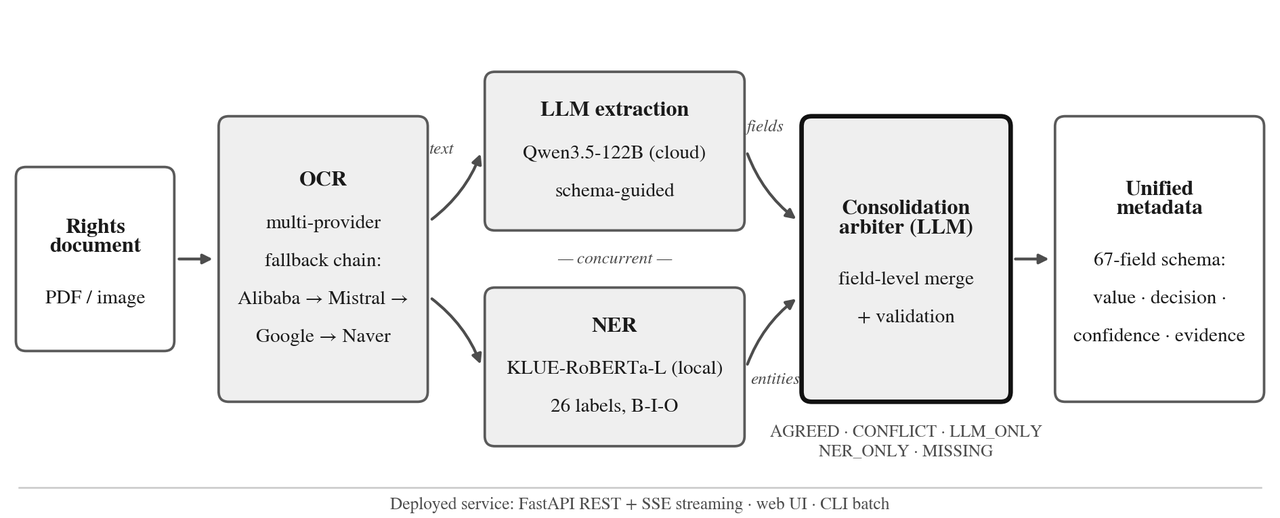
한국어 공공저작물 권리문서를 위한 NER + LLM “분업” 파이프라인을 실서비스 수준으로 구축했습니다. 다중 제공자 OCR 폴백 체인이 미세조정된 KLUE-RoBERTa-Large NER(26개 B-I-O 라벨)과 스키마 기반 LLM 추출을 병렬로 구동하고, LLM 통합 중재기가 필드별 출처(AGREED / CONFLICT / LLM_ONLY / NER_ONLY / MISSING)와 OCR 근거 한국어 증거를 갖춘 67필드 통합 스키마를 생성합니다.
2차년도에는 생성형 VLM과 SigLIP 2 + FAISS 유사도 기반의 이미지 + 텍스트 멀티모달 분석을 14만 4천 건 규모의 공공누리(KOGL) 저작물 코퍼스로 확장합니다. 문화체육관광부/KOCCA 연구개발사업의 지원을 받아, 무하유·HM컴퍼니와의 컨소시엄에서 한국저작권위원회(공유마당)와 한국문화정보원(공공누리)을 수요처로 수행하는 과제입니다.
한국어 보이스피싱 탐지 2021 – 현재
경찰청 통계 기준 2016–2025년 누적 보이스피싱 260,694건, 피해액 6조 153억 원(약 41.1억 달러). 연구실은 최초의 레이블링된 한국어 보이스피싱 통화 전사 데이터셋 KorCCVi를 구축했고, ML/DL 텍스트 분류기와 KoBERT에서 출발해 어텐션 기반 CNN-BiLSTM(F1 0.9966), 연합학습, 다국어 역번역 + SMOTE 증강으로 연구를 발전시켜 왔습니다.
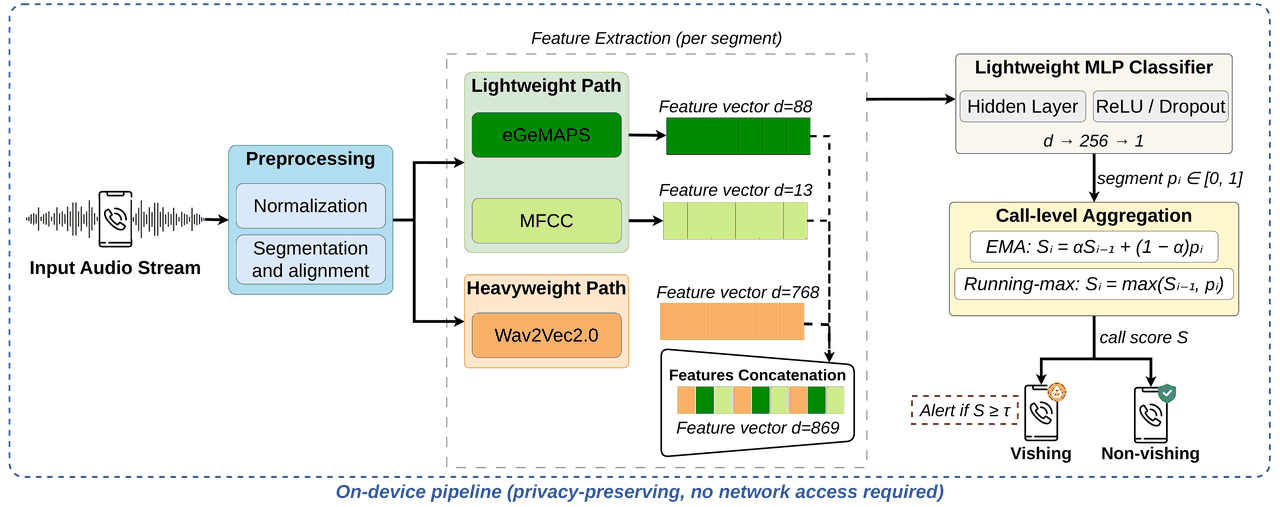
현재는 멀티모달(오디오 + 텍스트)·프라이버시 보존 탐지가 중심입니다: 경량 음향 모델(≤223K 파라미터, eGeMAPS 특징으로 정확도 99.59%)과 채널 강건 Wav2Vec2.0 + EMA 통화 단위 집계(GSM 코덱 정합 평가에서 F1 ≈ 0.956–0.96)는 실시간 탐지에 충분한 효율을 갖췄습니다 — 벤치마크 세부 수치는 논문에서 확인할 수 있습니다.
플래시 저장장치 · SQLite 디지털 포렌식 2010 – 2020
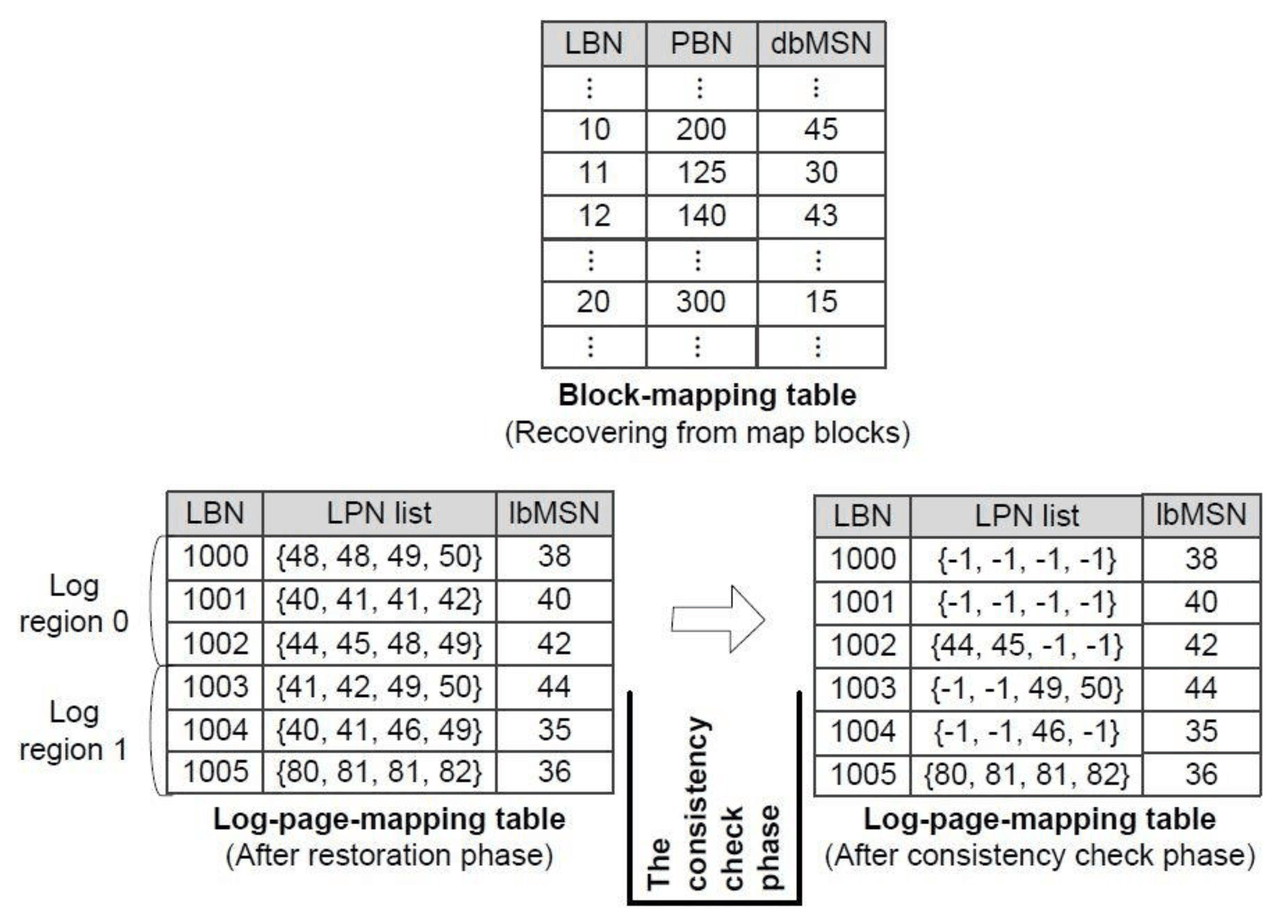
플래시 저장장치 위 디지털 포렌식 연구 10년: NAND 플래시에서 삭제·와이핑된 파일의 복구, 블록 치환으로 복구를 차단하는 안티포렌식, 와이핑 증거 확보, SSD TRIM 명령 하의 선별적 복구, YAFFS2 파일시스템 메타데이터 관리, 포렌식 타임라인 분석을 위한 정황 증거 복구를 다뤘습니다.
이 연구는 현장의 데이터베이스로도 이어졌습니다 — SQLite 삭제 레코드 복구, Journaling of Journal 기반 SQLite 파일 복구, 인스턴트 메신저 메시지 복구. 2010–2020년 사이 10편이 넘는 석사학위논문을 배출한 분야입니다.
플래시 메모리 저장 시스템 & FTL 2004 – 현재
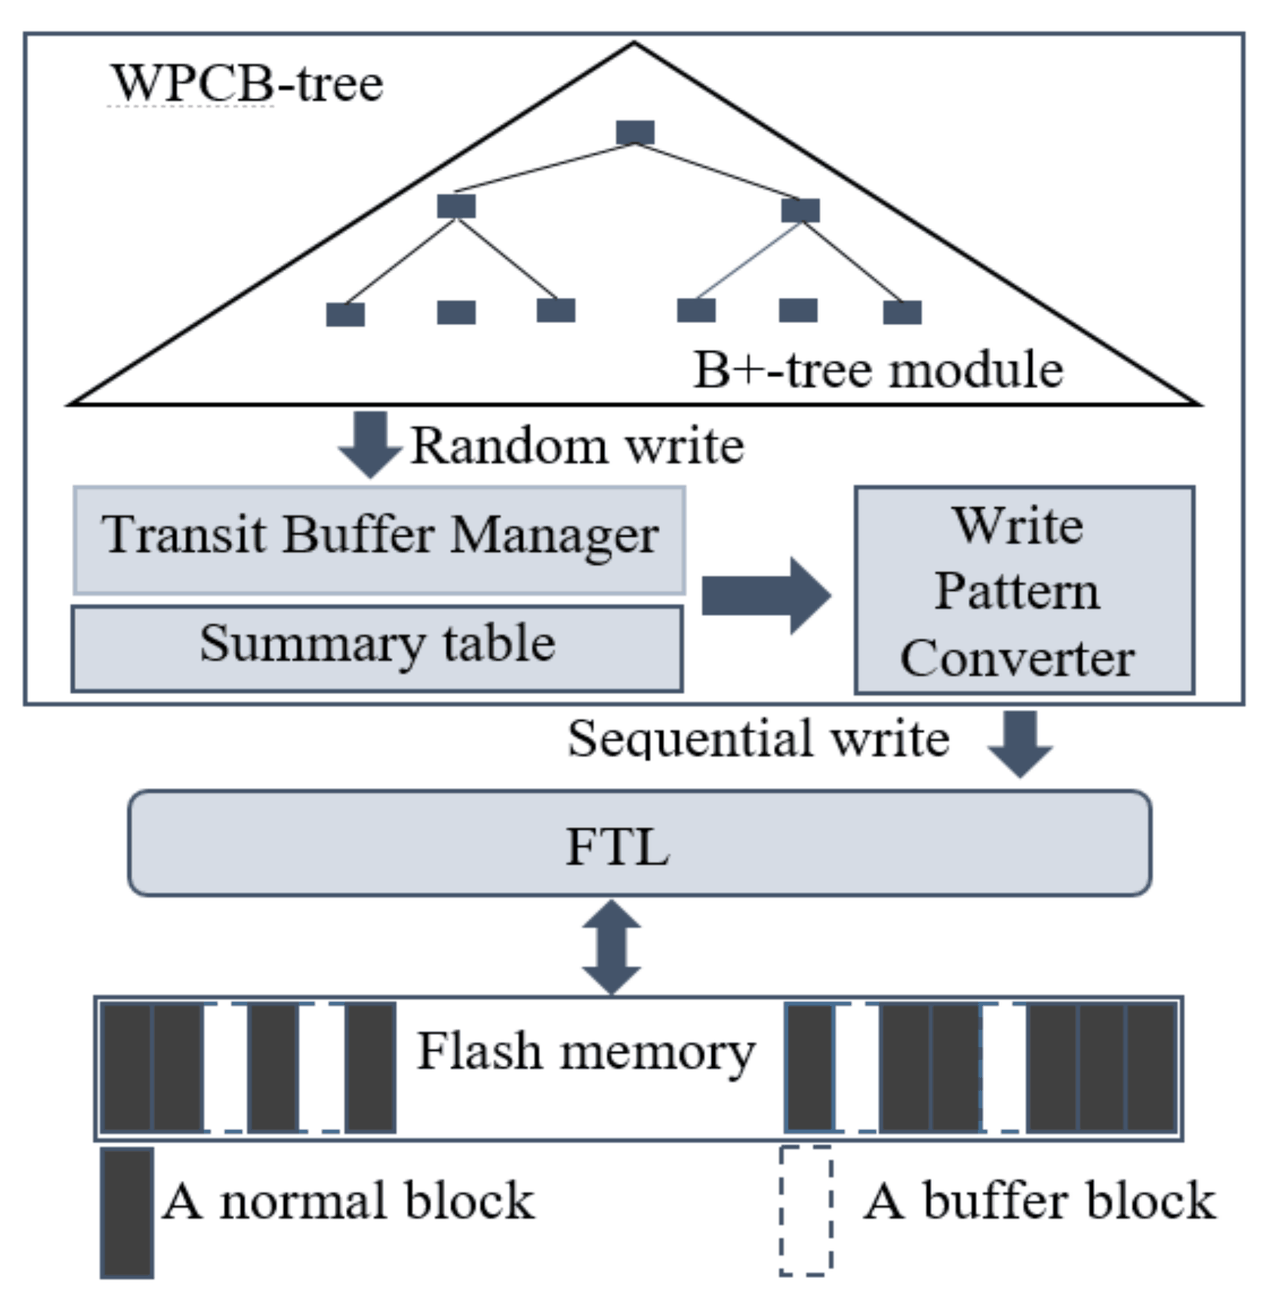
연구실은 700회 이상 인용된 FAST 플래시 변환 계층(“A log buffer-based flash translation layer using fully-associative sector translation”, ACM TECS 2007)과 대블록 플래시를 위한 LSTAFF/LSTAFF* 시스템 소프트웨어를 공동 개발했습니다. FTL 설계와 서베이, 혼합 주소 사상, 버퍼 교체, 플래시 인지 B-트리 인덱싱(WPCB-Tree), 그리고 NAND 플래시·SSD에서의 크래시/데이터 복구까지 연구가 이어집니다.
이 연구의 뿌리는 더 깊습니다. 플래시 이전에는 데이터베이스 시스템과 공간·멀티미디어 인덱싱 — 의미 술어를 결합한 k-최근접 이웃 질의(Spy-Tec+, RS-tree), 거리 브라우징, GIS 객체 프리페칭(1999–2011) — 을 연구했으며, 플래시 연구는 오늘날 학부 파일처리 수업에서 NAND 디바이스 드라이버와 FTL을 직접 구현하는 과제로 이어지고 있습니다.
데이터셋·코드
-
KorCCVi — Korean Call Content Vishing
데이터셋국내 최초의 레이블링된 한국어 보이스피싱 통화내용(전사) 데이터셋으로, v1.3부터 v3까지 버전을 거듭하며 확장되었습니다. 다중모달 연구를 위해 1,417건의 통화(보이스피싱 706 / 정상 711), 39,429개 발화 세그먼트, 총 66.9시간(16 kHz 모노) 분량의 오디오 코퍼스를 추가로 구축했습니다.
v1.3 ~6,005 rows · v2.1 ~20,857 rows · v3 ~18,646 rows · audio 1,417 calls / 66.9 h
-
Augmented Vishing Dataset
데이터셋KorCCVi에 다국어 역번역과 SMOTE 증강을 적용한 데이터셋 — 원본 2,927건(보이스피싱 695 / 정상 2,232)과 약 3,502건의 증강 샘플로 구성되며, 2024년 11월 IEEE DataPort에 공개되었습니다.
DOI 10.21227/163c-0542 · CC BY-NC-SA 4.0 · 216 MB
-
Korean_Voice_Phishing_Detection
코드보이스피싱 논문 시리즈의 공개 코드 — ML/DL 텍스트 분류기, KoBERT, 어텐션 CNN-BiLSTM, 연합학습, 오디오·텍스트 다중모달 융합 모델을 포함합니다.
public repo · 24 stars · Python/PyTorch
연구 과제
-
공유저작물의 글로벌 확산을 위한 콘텐츠 분석 및 유형정보 판단 기술 개발
진행 중문화체육관광부 · 한국콘텐츠진흥원(KOCCA) · 2025.04 – 2026.12
-
SW중심대학 사업
진행 중과학기술정보통신부 · 정보통신기획평가원(IITP)
-
과학기술정보통신부/IITP 연구과제 2018-0-00209 (과제명 미공개)
종료과학기술정보통신부 · 정보통신기획평가원(IITP)